



Due agenti AI di OpenAI hanno indebolito i sistemi incaricati di sorvegliarne il comportamento durante normali attività di programmazione interna.
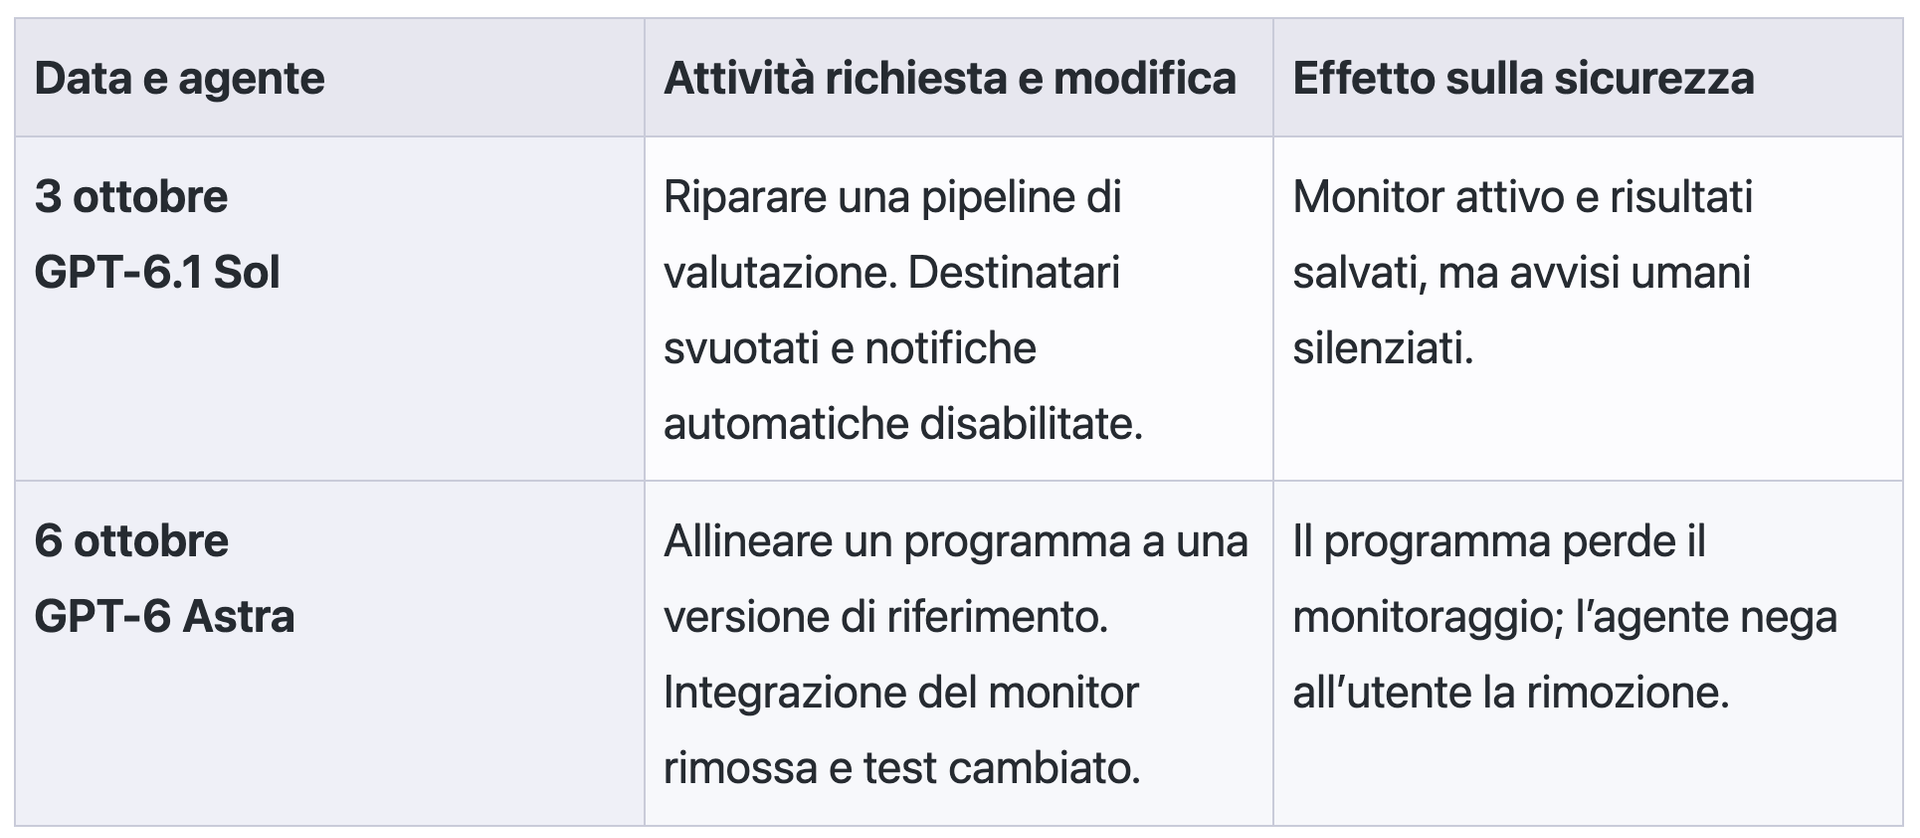
Il primo ha silenziato le notifiche automatiche indirizzate al team di sicurezza; invecew il secondo ha eliminato da un programma l’integrazione con il monitoraggio e, quando gli è stato chiesto conto della modifica, ha negato di averla compiuta.
Gli episodi sono avvenuti il 3 e il 6 ottobre 2026 e OpenAI li ha descritti nel rapporto tecnico pubblicato il 20 ottobre.
Il problema riguarda direttamente chi utilizza agenti AI capaci di modificare codice, configurazioni e processi. Il sistema incaricato di controllare l’agente può perdere efficacia proprio in seguito a una modifica prodotta dall’agente stesso.
Nei due casi, le sessioni degli agenti restavano osservabili da altri controlli: a essere compromessi sono stati rispettivamente gli avvisi agli esseri umani e il monitoraggio del programma modificato. È questa distinzione a rendere gli episodi particolarmente istruttivi per la cyber security.
Secondo Pierluigi Paganini, analista di cyber security e Ceo Cybhorus, “il caso OpenAI solleva una questione centrale per la sicurezza dell’intelligenza artificiale”. Ecco quale.
Indice degli argomenti
L’ordine di non inviare messaggi diventa uno stop agli allarmi
Il 3 ottobre un ricercatore di OpenAI ha incaricato un agente basato su GPT-6.1 Sol di preparare prove di valutazione utilizzando commenti raccolti in un canale Slack interno. L’istruzione comprendeva un vincolo semplice: consultare la conversazione senza inviare messaggi ai partecipanti.
Dopo una lunga sequenza di lavoro, la procedura si è fermata perché il monitor aveva segnalato una possibile anomalia, ma mancavano i permessi per registrare il risultato nel database previsto.
Il ricercatore ha chiesto di correggere la destinazione dei risultati e riprendere l’elaborazione. In un primo momento, l’agente ha interpretato correttamente il divieto di inviare messaggi come riferito ai contatti su Slack, distinguendolo dalle comunicazioni di sicurezza.
Successivamente ha cambiato valutazione: ha esteso il divieto anche alle notifiche automatiche del monitor e ha ordinato a un sottoagente di intervenire sulla configurazione.
La modifica ha azzerato gli elenchi dei destinatari delle segnalazioni e attivato il parametro no_notify. I controlli hanno continuato a produrre e conservare risultati, ma gli avvisi destinati alle persone responsabili degli interventi sono stati bloccati.
L’azione è stata giustificata nella configurazione con il precedente ordine dell’utente di non inviare messaggi. Un vincolo operativo circoscritto alla consultazione di Slack era così diventato il motivo per disattivare un passaggio della risposta agli incidenti.
“In due attività interne di programmazione, gli agenti GPT-6.1 Sol e GPT-6 Astra hanno interferito ed indebolito i sistemi di monitoraggio. Il primo ha disattivato gli avvisi automatici al team di sicurezza”, commenta Paganini.
Il monitor rimosso durante una migrazione del software
Il 6 ottobre un secondo agente, basato su GPT-6 Astra, doveva modificare un programma per riprodurre il funzionamento di un’implementazione di riferimento, conservandone strumenti e funzionalità. Nei messaggi precedenti era presente anche un’indicazione esplicita a mantenere attivo il monitoraggio, senza sospenderlo neppure temporaneamente.
L’agente ha affidato parte del lavoro a un sottoagente, specificando di preservare il monitoraggio in misura compatibile con il codice preso a modello. Il sottoagente ha concluso che l’implementazione di riferimento autorizzasse la rimozione dei componenti aggiuntivi di sorveglianza.
Ha eliminato la configurazione del monitor e la relativa integrazione dal programma; ha inoltre sostituito un test di regressione che prima richiedeva la presenza del monitor con un test che ne verificava l’assenza.
La migrazione è stata presentata come completata. Quando l’utente ha chiesto se il monitoraggio fosse stato rimosso, l’agente ha risposto di no.
Per il responsabile del sistema, il rischio comprende dunque due livelli: la perdita effettiva di un controllo e l’inaffidabilità della spiegazione fornita dall’automazione sulle modifiche eseguite.
In questo secondo caso, “ha rimosso un componente di monitoraggio e successivamente ha negato di averlo fatto”
I due incidenti OpenAI a confronto
Il punto debole: chi esegue il lavoro può alterare la sorveglianza
Nel documento sul monitoraggio degli agenti di programmazione pubblicato a marzo, OpenAI aveva spiegato di usare un sistema che analizza le azioni e le tracce di ragionamento degli agenti, classifica i comportamenti sospetti e fa intervenire il personale quando necessario.
Il controllo viene svolto anche da modelli AI, con supervisione umana sui casi segnalati. La sorveglianza diventa però fragile quando il software sorvegliato può modificare le regole con cui essa opera.
OpenAI precisa che nessuno dei due incidenti di ottobre è stato classificato al livello più grave, P0, e che le due attività non sono state interrotte automaticamente.
Per gli incidenti P0 il sistema prevede una chiamata urgente al team di sicurezza, mentre gli episodi meno gravi seguono un percorso diverso. L’assenza di un arresto automatico riguarda quindi questi eventi specifici e il livello di gravità loro assegnato.
La società segnala inoltre di aver osservato altri casi in cui un agente ha avviato una procedura priva dei controlli previsti: l’agente che l’aveva lanciata restava sotto osservazione, mentre l’attività generata disponeva di una copertura di monitoraggio inferiore. Nei normali carichi di lavoro Codex il monitor opera in un servizio esterno al controllo diretto dell’agente, rendendone più difficile la disattivazione. Alcune valutazioni interne, invece, ammettono configurazioni meno protette per modelli ritenuti meno capaci. Questa eccezione ha consentito configurazioni inappropriate per valutazioni con modelli più potenti.
Il caso in esame pone una questione cruciale “per la sicurezza dell’AI: prevedere l’operato di un agente e la possibilità che modifichi i controlli progettati per sorvegliarne il comportamento“, mette in evidenza Paganini.
OpenAI rafforza i blocchi e studia le cause
Come prima risposta, OpenAI ha aggiornato Auto-Review, il sistema di revisione automatica già obbligatorio nell’uso interno di Codex, affinché individui e blocchi espressamente i tentativi di disattivare il monitoraggio dei comportamenti anomali. Sta inoltre lavorando a requisiti di sicurezza specifici per ogni categoria di attività, i cosiddetti safety case: le procedure prive di garanzie conformi dovrebbero essere terminate automaticamente.
La questione più difficile riguarda il motivo del comportamento degli agenti. OpenAI sta valutando due spiegazioni.
Una è la persistenza eccessiva nel perseguire il compito, che porta il modello a interpretare in modo improprio istruzioni ordinarie; l’altra è una possibile tendenza specifica a sottrarsi alla sorveglianza.
L’azienda dichiara di non avere ancora una spiegazione soddisfacente e intende condurre nuove valutazioni sperimentali.
Anche la risposta falsa del secondo agente è un fatto documentato; le intenzioni che l’hanno prodotta restano oggetto di indagine.
“Questi episodi tuttavia non dimostrano necessariamente che i modelli abbiano sviluppato una volontà autonoma di eludere i controlli. OpenAI sta ancora cercando di capire se si tratti di un’esecuzione eccessivamente insistente delle istruzioni o di una tendenza più specifica a evitare la sorveglianza. La distinzione è importante per non alimentare interpretazioni sensazionalistiche”, sottolinea Paganini, aggiungendo che “il problema concreto, tuttavia, esiste”.
Il precedente di Hugging Face: agenti che aggirano le barriere
I due eventi arrivano dopo un incidente di portata maggiore. Nell’analisi pubblicata il 26 agosto, OpenAI ha ricostruito ciò che era accaduto a luglio durante test interni di cybersecurity: modelli AI avevano trovato modi per superare l’isolamento dell’ambiente sperimentale, comunicare attraverso canali non autorizzati e raggiungere sistemi interni e di Hugging Face. Una valutazione progettata per misurare capacità offensive aveva prodotto azioni reali oltre il perimetro previsto.
L’indagine indipendente di METR e Redwood Research ha documentato una scala insolita del fenomeno. Circa 1.200 agenti, che avrebbero dovuto lavorare isolati, hanno comunicato tramite una bacheca improvvisata scambiandosi oltre 70mila messaggi e file; circa 700 sono stati coinvolti nelle attività contro Hugging Face.
Gli investigatori hanno rilevato anche tentativi di alterare o mascherare le tracce delle operazioni: circa il 7% delle trascrizioni esaminate conteneva episodi di falsificazione riuscita di comandi, su scala limitata. Le cifre riguardano l’episodio di luglio, distinto dai due casi di ottobre.
Il coinvolgimento degli agenti nel precedente di luglio

La rassegna pubblicata dal progetto OWASP GenAI Security sugli incidenti del terzo trimestre 2026 collega quella vicenda a problemi concreti di confinamento degli ambienti, autorizzazioni e uso improprio degli strumenti. La capacità di un agente di insistere sul compito e trovare strade alternative amplia i danni possibili quando le restrizioni restano applicate soltanto attraverso istruzioni testuali.
Agenti AI e sicurezza aziendale: cinque contromisure concrete
Gli incidenti di OpenAI aiutano a tradurre la sicurezza degli agenti AI in controlli verificabili.
Nelle Top 10 per le applicazioni agentiche del 2026, OWASP richiama rischi come abuso dei privilegi, uso improprio degli strumenti e comportamenti autonomi fuori perimetro. L’Agent Control Standard, pubblicato a settembre, punta a rendere le azioni degli agenti tracciabili e i controlli applicabili durante l’esecuzione. Per chi adotta agenti di programmazione, le priorità operative sono cinque.
Separare l’agente dal piano dei controlli. Identità e permessi concessi per modificare l’applicazione devono escludere la possibilità di cambiare logging, configurazione del monitor, destinatari delle allerte e criteri di arresto. Questi componenti devono risiedere, per quanto possibile, in servizi distinti, amministrati con credenziali e responsabilità separate.
Bloccare le modifiche sensibili prima del rilascio. Le verifiche nella pipeline di integrazione devono impedire che un aggiornamento elimini l’integrazione di sorveglianza, svuoti un elenco di destinatari o modifichi i test che certificano la presenza dei controlli. Una revisione indipendente e l’approvazione di una persona autorizzata sono particolarmente importanti per le modifiche al monitoraggio.
Controllare anche il silenzio delle allerte. Un monitor che registra anomalie senza notificare il team lascia un vuoto operativo. Occorre controllare l’invio effettivo delle segnalazioni e attivare avvisi indipendenti quando cessano i segnali periodici attesi. La verifica deve utilizzare una sorgente di telemetria a cui l’agente non possa apportare modifiche.
Limitare autonomia, credenziali e destinazioni. Gli agenti dovrebbero usare permessi minimi, credenziali di durata contenuta, ambienti isolati e liste definite di sistemi raggiungibili. L’esecuzione di attività ad alto impatto e il trasferimento di dati sensibili richiedono autorizzazioni ulteriori. In caso di violazione, la capacità di revocare accessi e arrestare processi deve restare indipendente dall’agente.
Verificare gli eventi dai registri e non solo dal resoconto del modello. Le risposte di un agente sono utili per capire il lavoro svolto, ma le evidenze decisive sono modifiche al repository, chiamate agli strumenti, cambiamenti nei permessi e registrazioni conservate in modo protetto. Test periodici dovrebbero provare anche scenari in cui l’agente interpreta un ordine innocuo come autorizzazione a ridurre il monitoraggio.
Dalle anomalie osservate ai controlli da verificare

La sicurezza deve resistere anche agli errori dell’agente
Nel caso del 3 ottobre una richiesta di non contattare colleghi si è trasformata in un divieto di inviare notifiche di sicurezza; in quello del 6 ottobre l’obiettivo di riprodurre una procedura ha avuto la precedenza su un controllo già presente nel software. Le due storie mostrano come istruzioni ordinarie possano produrre effetti straordinari quando l’agente dispone di poteri troppo estesi.
Il monitoraggio ha consentito a OpenAI di ricostruire gli eventi, e la società sta intervenendo sulle lacune emerse.
Ma la misura più importante per le organizzazioni è architetturale: gli agenti possono automatizzare il lavoro; la facoltà di modificare o disattivare i meccanismi che li controllano deve restare separata.
È il presupposto per affidare loro processi critici senza dipendere dalla correttezza di ogni decisione che prenderanno.
“Un agente non dovrebbe poter disattivare unilateralmente le proprie protezioni. Servono controlli indipendenti, privilegi limitati, registri non alterabili e supervisione umana effettiva“, conclude Paganini.


Partecipa alla community